您喝了七杯同樣的拿鐵咖啡。每一個都略有不同:微小的角度變化、微小的燈光變化、您的手移動了 2 公分。對於加密雜湊函數(MD5、SHA-256)來說,這七張照片完全唯一-沒有一個位元匹配。對於人眼來說,它們本質上是相同的。
機器級唯一性與人類感知相似性之間的差距是感知哈希解決的根本問題。它是每個現代複製照片清潔器背後的核心技術,了解其工作原理可以揭示為什麼某些清潔器比其他清潔器更準確。
5 個等級的照片相似性檢測
照片相似度在一個範圍內運作。現代檢測系統同時使用多種技術,每種技術針對不同等級進行了最佳化:
| 等級 | 檢測方法 | 它捕捉了什麼 | 速度 | 準確度 |
|---|---|---|---|---|
| 1.位元組相同 | 加密哈希 (MD5/SHA-256) | 精確檔案副本、AirDrop 副本 | 最快 | 100%(但較窄) |
| 2.像素相同 | 平均哈希值 (aHash) | 同一影像的重新儲存或重新編碼版本 | 非常快速 | 85% |
| 3.視覺上相似 | 感知哈希(pHash/dHash) | 裁切、過濾或稍微旋轉的版本 | 快 | 92% |
| 4.語意相似 | 神經嵌入(CNN/Vision Transformer) | 不同角度的相同場景,突發序列 | 中 | 97% |
| 5。概念相關 | CLIP 式多模式模型 | 同一主題或主題的不同照片 | 慢 | 上下文相關 |
為什麼 MD5 校驗和會失去 80% 的視覺重複項
MD5 和 SHA-256 等加密雜湊是為資料完整性驗證而設計的,而不是視覺相似性。它們產生固定長度的摘要,其中更改輸入中的單位元會產生完全不同的雜湊值。這意味著:
- 以不同的品質等級重新儲存 JPEG → 全新的雜湊
- 將 HEIC 轉換為 JPEG → 全新哈希
- 從邊緣裁切 2 個像素 → 全新的雜湊
- 新增 Instagram 濾鏡 → 全新哈希
- 同一張照片的螢幕截圖 → 全新的哈希
在現實世界的相機膠卷中,只有大約 15-20% 的重複項是精確的位元組級副本(通常來自 AirDrop 傳輸或雲端同步錯誤)。其餘 80% 是需要感知分析的視覺重複。
感知哈希的工作原理(pHash 和 dHash)
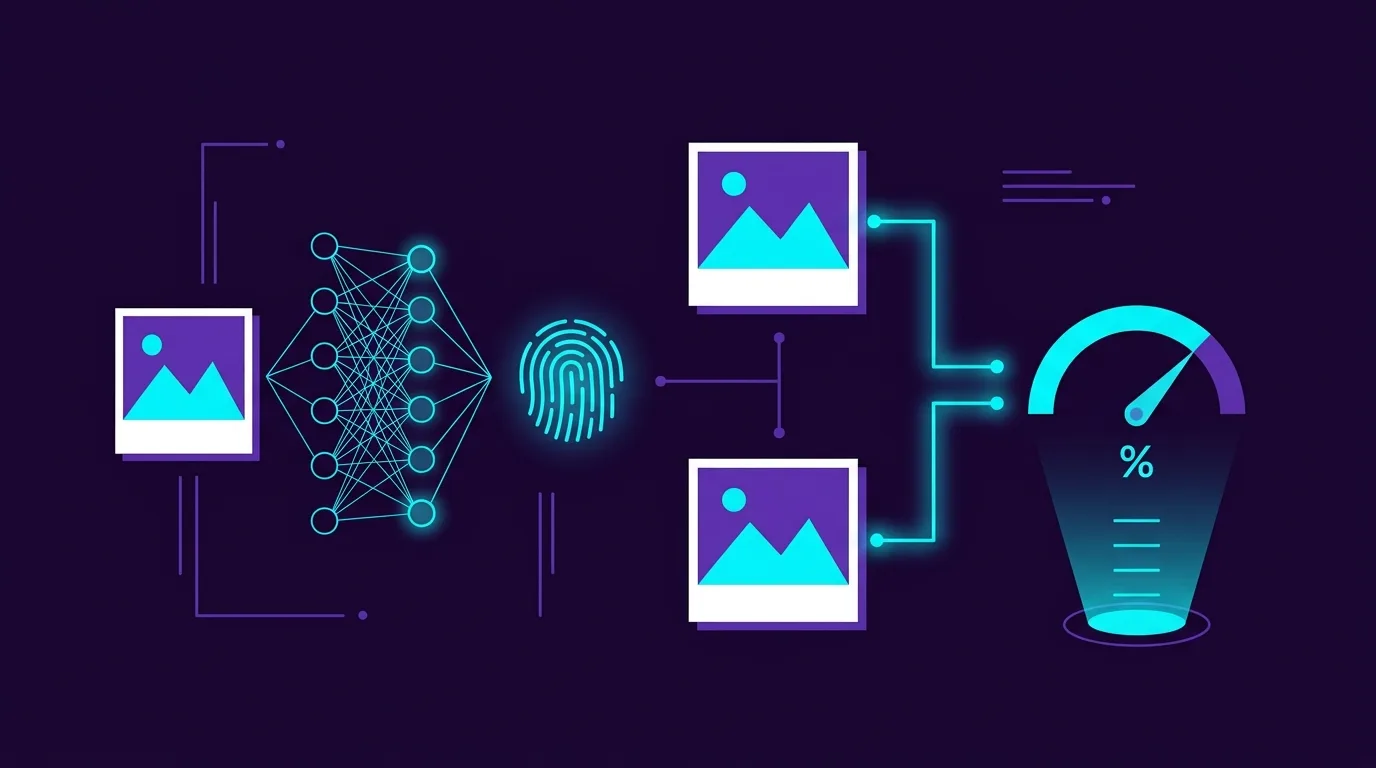
感知雜湊產生緊湊的指紋,捕捉影像的視覺結構,而不是其原始位元組內容。該演算法遵循一般流程:
- 調整為小網格:影像被縮小到較小的解析度(通常為 8×8 或 32×32 像素),破壞精細細節,但保留整體亮度結構。
- 轉換為灰階:顏色資訊被丟棄。感知相似性主要與結構有關,而不是色調——一張帶有暖色濾鏡的照片和一張帶有冷色濾鏡的照片應該仍然匹配。
- 計算梯度或平均值:對於 dHash(差異雜湊),每個像素都會與其右鄰居進行比較。對於 aHash(平均哈希),每個像素都會與網格的平均亮度進行比較。每次比較都會產生一個位元:更亮 = 1,更暗 = 0。
- 產生二進位指紋:結果是 64 位元 (8×8) 或 1024 位元 (32×32) 二進位字串 — 感知雜湊。
- 使用漢明距離進行比較:透過計算兩個影像的雜湊值之間有多少位元不同來比較兩個影像。漢明距離 0 = 相同的結構。距離 ≤ 5(滿分 64)= 視覺上幾乎相同。距離 ≤ 10 = 可能相似。
為什麼 pHash 適用於過濾後的照片
由於演算法在步驟 1-2 中丟棄了顏色和精細細節,因此經過 Instagram 過濾的照片版本會產生與原始照片幾乎相同的感知哈希值。無論顏色分級如何,大範圍的亮度結構(頂部明亮的天空,底部黑暗的地面)都保持不變。
SSIM:測量人眼實際看到的內容
結構相似度指數 (SSIM),由 Wang 等人所發展。 2004 年,超越了二進制哈希。它根據反映人類視覺感知的三個組成部分計算連續相似性得分(0.0 到 1.0):
- 亮度比較:平均亮度等級是否相似? (補償曝光差異)
- 對比比較:影像的動態範圍是否相似?
- 結構比較:明暗區域的空間格局是否相符?
SSIM 分數高於 0.92 通常表示大多數觀看者在知覺上無法區分兩張影像。現代照片清理器使用此閾值自動標記接近重複的內容,同時保留真正不同的構圖。
神經嵌入:深度學習前緣
感知雜湊與語意相似性作鬥爭 - 從不同位置拍攝的相同場景的照片,或拍攝對像在畫面之間顯著移動的連拍序列。對於這些情況,裝置上的神經網路(卷積或 Vision Transformer 模型)會擷取高維嵌入向量。
其工作原理如下:神經網路處理每張照片並輸出一個 512 維浮點向量 - 本質上是編碼圖像語義內容的 512 個數字。從不同角度拍攝的同一日落的照片,相隔數秒,會產生在這個 512 維空間中幾何上接近的嵌入向量。
然後使用餘弦相似度測量相似度:兩個向量之間角度的餘弦。餘弦相似度 1.0 = 相同的語意內容。 0.85+ 的閾值可以捕捉突發序列、幾乎相同的成分以及僅感知散列會錯過的細微變化。
設備端處理與雲端處理:隱私維度
運行神經嵌入模型需要強大的運算能力。一些照片清理應用程式將圖像上傳到雲端 GPU 進行分析——這是一個巨大的隱私風險。現代 Apple 設備包括神經引擎(A17 Pro 為 16 核,M 系列為 5 TOPS),能夠完全在設備上運行 CoreML 視覺模型。這意味著可以在 3 分鐘內計算 10,000 張照片的 512 維嵌入,而無需任何資料離開裝置。
| 處理方式 | 速度(10K 照片) | 隱私權 | 準確度 |
|---|---|---|---|
| 雲端 GPU (NVIDIA A100) | 30 秒 | 上傳到外部伺服器的照片 | 最高(最大型號) |
| 設備內神經引擎 | 2–4 分鐘 | 100%本地,零網路傳輸 | 優秀(優化的 CoreML 模型) |
| 僅限設備內 CPU | 15–25 分鐘 | 100% 本地 | 良好(有限的模型複雜度) |
查看實際的神經重複偵測
Swipe Photo Cleaner (Wipe AI) 將用於快速初始過濾的感知哈希與用於深度語義分組的設備上 CoreML 神經嵌入相結合。結果:連拍序列、經過過濾的副本和幾乎相同的構圖會自動聚集在一起,並突出顯示最清晰的照片 - 所有這些都在設備的神經引擎上進行本地處理,而無需將單個字節上傳到雲端。
iPhone 潛在可釋放容量估算計算機
根據您的相片總量與儲存習慣,估算可清理的重複檔案與系統快取空間
HEIC vs JPEG iPhone 相片容量對比計算機
查看開啟 Apple 高效率 HEIF/HEIC 格式相比傳統 JPEG 節省的龐大容量
4K 影片 HEVC / ProRes 壓縮容量計算機
估算 iPhone 錄製不同幀率與編碼影片所需的儲存空間與壓縮節省率