Você toma sete doses do mesmo café com leite. Cada um é um pouco diferente: uma pequena mudança de ângulo, uma pequena mudança de iluminação, sua mão se moveu 2 centímetros. Para uma função hash criptográfica (MD5, SHA-256), essas sete fotos são completamente únicas — nem um único bit corresponde. Ao olho humano, eles são essencialmente idênticos.
Essa lacuna entre a exclusividade no nível da máquina e a similaridade percebida pelo homem é o problema fundamental que o hashing perceptual resolve. É a tecnologia central por trás de todos os limpadores de fotos duplicadas modernos, e a compreensão de como ela funciona revela por que alguns limpadores são dramaticamente mais precisos do que outros.
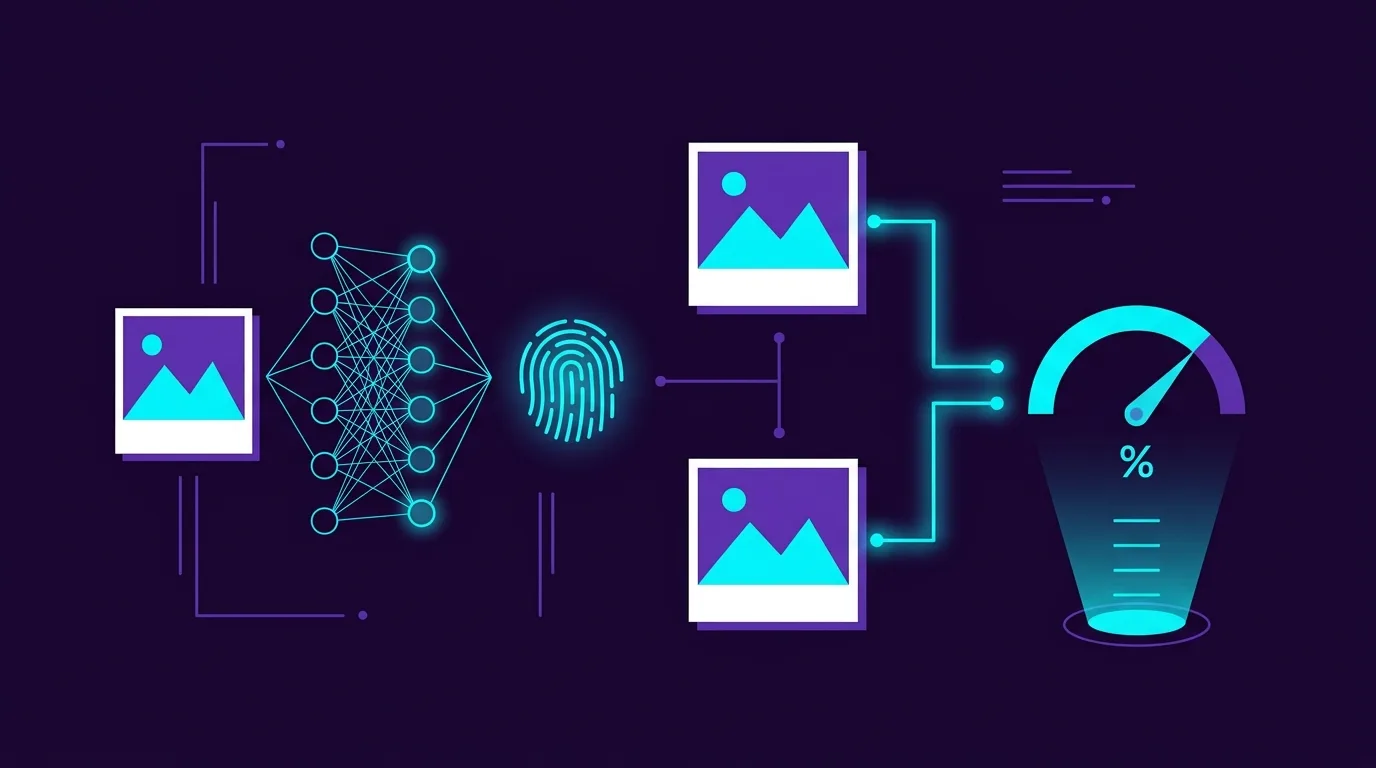
5 níveis de detecção de similaridade de fotos
A similaridade de fotos opera em um espectro. Os sistemas de detecção modernos utilizam múltiplas técnicas simultaneamente, cada uma otimizada para um nível diferente:
| Nível | Método de detecção | O que ele captura | Velocidade | Precisão |
|---|---|---|---|---|
| 1. Byte idêntico | Hash criptográfico (MD5/SHA-256) | Cópias exatas de arquivos, duplicatas do AirDrop | Mais rápido | 100% (mas estreito) |
| 2. Pixel idêntico | Hash médio (aHash) | Versões salvas novamente ou recodificadas da mesma imagem | Muito rápido | 85% |
| 3. Visualmente semelhante | Hash perceptual (pHash/dHash) | Versões cortadas, filtradas ou levemente giradas | Rápido | 92% |
| 4. Semanticamente semelhante | Embeddings neurais (CNN/Vision Transformer) | Mesma cena de ângulos diferentes, sequências burst | Moderado | 97% |
| 5. Conceitualmente relacionado | Modelos multimodais estilo CLIP | Fotos diferentes do mesmo assunto ou tema | Lento | Dependente do contexto |
Por que as somas de verificação MD5 perdem 80% das duplicatas visuais
Hashes criptográficos como MD5 e SHA-256 foram projetados para verificação de integridade de dados, não para similaridade visual. Eles produzem um resumo de comprimento fixo onde alterar um único bit na entrada produz um hash completamente diferente. Isso significa:
- Salvar novamente um JPEG com um nível de qualidade diferente → hash totalmente novo
- Convertendo HEIC em JPEG → hash totalmente novo
- Cortar 2 pixels da borda → hash totalmente novo
- Adicionando um filtro do Instagram → hash totalmente novo
- Capturas de tela da mesma foto → hash totalmente novo
Em rolos de câmera do mundo real, apenas cerca de 15–20% das duplicatas são cópias exatas em nível de byte (normalmente de transferências AirDrop ou erros de sincronização na nuvem). Os 80% restantes são duplicatas visuais que requerem análise perceptiva.
Como funciona o hash perceptual (pHash e dHash)
O hash perceptual gera uma impressão digital compacta que captura a estrutura visual de uma imagem em vez de seu conteúdo bruto de bytes. O algoritmo segue um pipeline geral:
- Redimensionar para uma grade minúscula: a imagem é reduzida para uma resolução pequena (normalmente 8×8 ou 32×32 pixels), destruindo detalhes finos, mas preservando a estrutura geral de luminância.
- Converter para escala de cinza: as informações de cor são descartadas. A semelhança perceptiva diz respeito principalmente à estrutura, não ao matiz. Uma foto com filtro quente e outra com filtro frio ainda devem corresponder.
- Calcular gradiente ou média: Para dHash (hash de diferença), cada pixel é comparado ao seu vizinho direito. Para aHash (hash médio), cada pixel é comparado com a luminância média da grade. Cada comparação produz um único bit: mais claro = 1, mais escuro = 0.
- Produzir impressão digital binária: O resultado é uma string binária de 64 bits (8×8) ou 1024 bits (32×32) — o hash perceptivo.
- Comparar usando a distância de Hamming: Duas imagens são comparadas contando quantos bits diferem entre seus hashes. Uma distância de Hamming de 0 = estrutura idêntica. Distância ≤ 5 (de 64) = visualmente quase idêntica. Distância ≤ 10 = provavelmente semelhante.
Por que o pHash funciona em fotos filtradas
Como o algoritmo descarta cores e detalhes finos na etapa 1–2, uma versão de uma foto filtrada pelo Instagram produz quase o mesmo hash perceptivo que a original. A estrutura de luminância em grande escala (céu claro na parte superior e fundo escuro na parte inferior) permanece idêntica, independentemente da gradação de cores.
SSIM: medindo o que o olho humano realmente vê
O Índice de Similaridade Estrutural (SSIM), desenvolvido por Wang et al. em 2004, vai além do hashing binário. Ele calcula uma pontuação de similaridade contínua (0,0 a 1,0) com base em três componentes que refletem a percepção visual humana:
- Comparação de luminância: os níveis médios de brilho são semelhantes? (Compensa diferenças de exposição)
- Comparação de contraste: as imagens têm faixa dinâmica semelhante?
- Comparação de estruturas: Os padrões espaciais das regiões claras e escuras correspondem?
Uma pontuação SSIM acima de 0,92 normalmente indica que duas imagens são perceptualmente indistinguíveis para a maioria dos espectadores. Os limpadores de fotos modernos usam esse limite para sinalizar automaticamente quase duplicatas, preservando composições genuinamente diferentes.
Embeddings Neurais: A Fronteira do Aprendizado Profundo
O hash perceptivo luta com a semelhança semântica — fotos da mesma cena tiradas de posições diferentes ou sequências contínuas em que o sujeito se moveu significativamente entre os quadros. Para esses casos, as redes neurais no dispositivo (modelos convolucionais ou Vision Transformer) extraem vetores de incorporação de alta dimensão.
Funciona assim: a rede neural processa cada foto e gera um vetor flutuante de 512 dimensões — essencialmente 512 números que codificam o conteúdo semântico da imagem. Fotos do mesmo pôr do sol, tiradas com segundos de diferença e de ângulos diferentes, produzem vetores incorporados que são geometricamente próximos neste espaço de 512 dimensões.
A similaridade é então medida usando a semelhança de cosseno: o cosseno do ângulo entre dois vetores. Uma similaridade de cosseno de 1,0 = conteúdo semântico idêntico. Um limite de 0,85+ captura sequências burst, composições quase idênticas e variações sutis que o hash perceptivo por si só não perceberia.
Processamento no dispositivo versus processamento na nuvem: a dimensão da privacidade
A execução de modelos de incorporação neural requer um poder computacional significativo. Alguns aplicativos de limpeza de fotos enviam suas imagens para GPUs em nuvem para análise – um enorme risco de privacidade. Os dispositivos modernos da Apple incluem o Neural Engine (16 núcleos no A17 Pro, 5 TOPS na série M), capaz de executar modelos de visão CoreML inteiramente no dispositivo. Isso significa que incorporações de 512 dimensões podem ser computadas para 10.000 fotos em menos de 3 minutos, sem que nenhum dado saia do dispositivo.
| Abordagem de processamento | Velocidade (10 mil fotos) | Privacidade | Precisão |
|---|---|---|---|
| GPU em nuvem (NVIDIA A100) | 30 segundos | Fotos enviadas para servidores externos | Mais alto (modelos maiores) |
| Mecanismo Neural no Dispositivo | 2–4 minutos | 100% local, transmissão de rede zero | Excelente (modelos CoreML otimizados) |
| Somente CPU no dispositivo | 15–25 minutos | 100% local | Bom (complexidade limitada do modelo) |
Veja a detecção neural duplicada em ação
Swipe Photo Cleaner (Wipe AI) combina hashing perceptivo para filtragem inicial rápida com incorporações neurais CoreML no dispositivo para agrupamento semântico profundo. O resultado: sequências burst, cópias filtradas e composições quase idênticas são automaticamente agrupadas com a foto mais nítida destacada – tudo processado localmente no Neural Engine do seu dispositivo sem carregar um único byte na nuvem.