Du tar sju shots av samma kaffe latte. Var och en är något annorlunda: en mindre vinkeländring, en liten belysningsförskjutning, din hand rörde sig 2 centimeter. Till en kryptografisk hashfunktion (MD5, SHA-256) är dessa sju foton helt unika - inte en enda bit matchar. För ett mänskligt öga är de i huvudsak identiska.
Denna klyfta mellan unikhet på maskinnivå och mänskligt upplevd likhet är det grundläggande problemet som perceptuell hash löser. Det är kärntekniken bakom alla moderna dubbletter av fotorengörare, och att förstå hur det fungerar avslöjar varför vissa rengöringsmedel är dramatiskt mer exakta än andra.
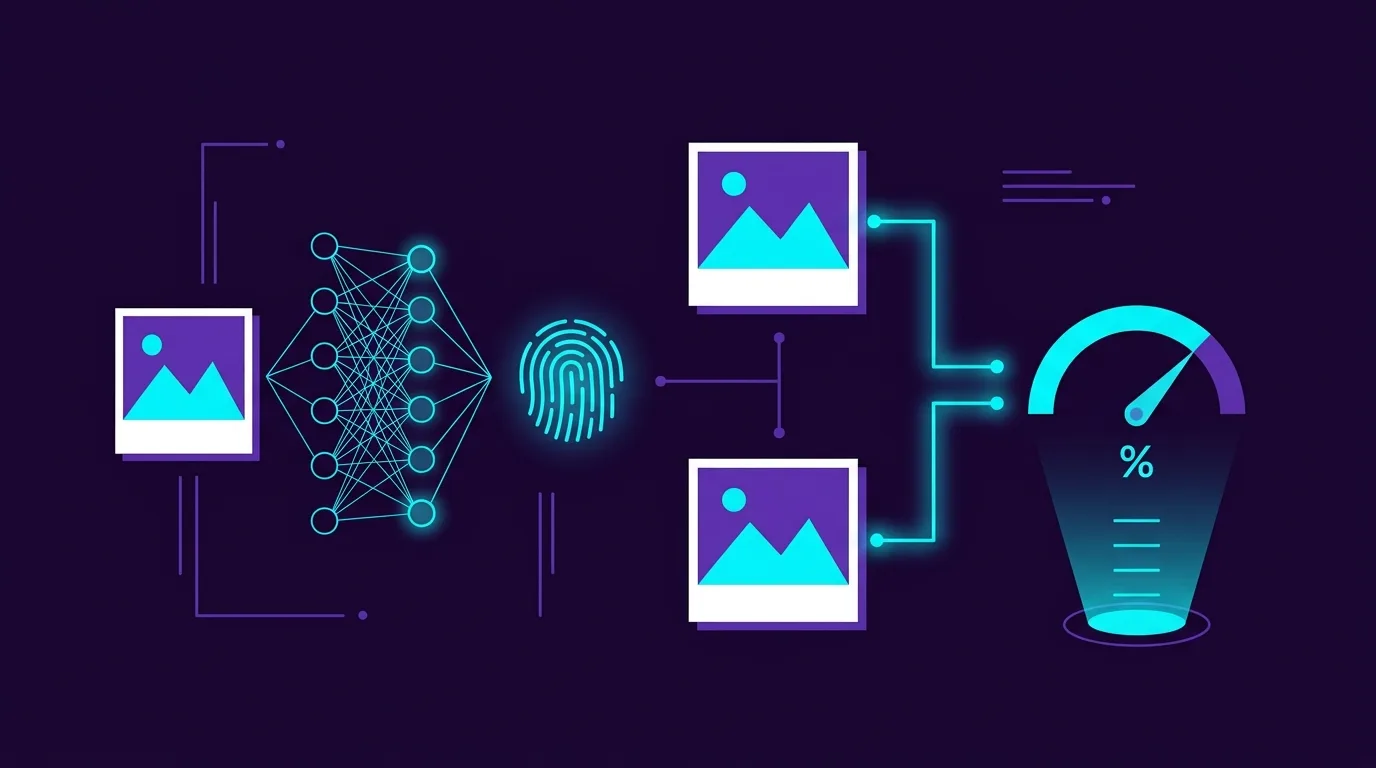
5 nivåer för detektering av fotolikhet
Fotolikhet verkar på ett spektrum. Moderna detekteringssystem använder flera tekniker samtidigt, var och en optimerad för olika nivåer:
| Nivå | Detektionsmetod | Vad den fångar | Hastighet | Noggrannhet |
|---|---|---|---|---|
| 1. Byte-identisk | Kryptografisk hash (MD5/SHA-256) | Exakta filkopior, AirDrop-dubbletter | Snabbast | 100 % (men smalt) |
| 2. Pixelidentiska | Genomsnittlig hash (aHash) | Återsparade eller omkodade versioner av samma bild | Mycket snabbt | 85 % |
| 3. Visuellt lika | Perceptuell hash (pHash/dHash) | Beskurna, filtrerade eller något roterade versioner | Snabb | 92 % |
| 4. Semantiskt lika | Neurala inbäddningar (CNN/Vision Transformer) | Samma scen från olika vinklar, seriesekvenser | Moderera | 97 % |
| 5. Konceptuellt relaterat | Multimodala modeller i CLIP-stil | Olika foton av samma ämne eller tema | Långsam | Kontextberoende |
Varför MD5-kontrollsummor missar 80 % av visuella dubbletter
Kryptografiska hash som MD5 och SHA-256 utformades för verifiering av dataintegritet, inte visuell likhet. De producerar ett sammandrag med fast längd där ändring av en enstaka bit i ingången producerar en helt annan hash. Det betyder:
- Spara en JPEG på nytt på en annan kvalitetsnivå → helt ny hash
- Konvertera HEIC till JPEG → helt ny hash
- Beskär 2 pixlar från kanten → helt ny hash
- Lägga till ett Instagram-filter → helt ny hash
- Skärmbilder av samma foto → helt ny hash
I verkliga kamerarullar är endast cirka 15-20 % av kopiorna exakta kopior på bytenivå (vanligtvis från AirDrop-överföringar eller molnsynkroniseringsfel). De återstående 80 % är visuella dubbletter som kräver perceptuell analys.
Hur perceptuell hashing fungerar (pHash och dHash)
Perceptuell hash genererar ett kompakt fingeravtryck som fångar den visuella strukturen av en bild snarare än dess råa byteinnehåll. Algoritmen följer en allmän pipeline:
- Ändra storlek till ett litet rutnät: Bilden skalas ned till en liten upplösning (vanligtvis 8×8 eller 32×32 pixlar), vilket förstör fina detaljer men bevarar den övergripande luminansstrukturen.
- Konvertera till gråskala: Färginformation kasseras. Perceptuell likhet handlar i första hand om struktur, inte nyans - ett foto med ett varmt filter och ett med ett kallt filter bör fortfarande matcha.
- Beräkna gradient eller medelvärde: För dHash (differenshash) jämförs varje pixel med sin högra granne. För aHash (genomsnittlig hash) jämförs varje pixel med rutnätets medelluminans. Varje jämförelse ger en enda bit: ljusare = 1, mörkare = 0.
- Producera binärt fingeravtryck: Resultatet är en 64-bitars (8×8) eller 1024-bitars (32×32) binär sträng - den perceptuella hashen.
- Jämför med Hamming-avstånd: Två bilder jämförs genom att räkna hur många bitar som skiljer sig mellan deras hash. Ett Hamming-avstånd på 0 = identisk struktur. Avstånd ≤ 5 (av 64) = visuellt nästan identisk. Avstånd ≤ 10 = förmodligen liknande.
Varför pHash fungerar på filtrerade foton
Eftersom algoritmen förkastar färg och fina detaljer i steg 1-2, producerar en Instagram-filtrerad version av ett foto nästan samma perceptuella hash som originalet. Den storskaliga luminansstrukturen - ljus himmel upptill, mörk mark nertill - förblir identisk oavsett färggradering.
SSIM: Mätning av vad det mänskliga ögat faktiskt ser
Structural Similarity Index (SSIM), utvecklat av Wang et al. 2004, går utöver binär hash. Den beräknar ett kontinuerligt likhetspoäng (0,0 till 1,0) baserat på tre komponenter som speglar mänsklig visuell perception:
- Luminansjämförelse: Är de genomsnittliga ljusstyrkorna liknande? (Kompenserar för exponeringsskillnader)
- Kontrastjämförelse: Har bilderna liknande dynamiskt omfång?
- Strukturjämförelse: Matchar de rumsliga mönstren för ljusa och mörka områden?
Ett SSIM-poäng över 0,92 indikerar vanligtvis att två bilder är perceptuellt omöjliga att särskilja för de flesta tittare. Moderna fotorengörare använder denna tröskel för att automatiskt flagga nästan dubbletter samtidigt som de bevarar genuint olika kompositioner.
Neurala inbäddningar: The Deep Learning Frontier
Perceptuell hash kämpar med semantisk likhet - foton av samma scen tagna från olika positioner, eller seriesekvenser där motivet rörde sig betydligt mellan bildrutor. I dessa fall extraherar neurala nätverk på enheten (convolutional eller Vision Transformer-modeller) högdimensionella inbäddningsvektorer.
Så här fungerar det: det neurala nätverket bearbetar varje foto och matar ut en 512-dimensionell flytvektor - i huvudsak 512 siffror som kodar bildens semantiska innehåll. Foton av samma solnedgång, tagna med sekunders mellanrum från olika vinklar, producerar inbäddningsvektorer som är geometriskt nära i detta 512-dimensionella utrymme.
Likhet mäts sedan med cosinuslikhet: cosinus för vinkeln mellan två vektorer. En cosinuslikhet på 1,0 = identiskt semantiskt innehåll. En tröskel på 0,85+ fångar upp seriesekvenser, nästan identiska kompositioner och subtila variationer som bara perceptuell hash skulle missa.
On-Device vs Cloud Processing: The Privacy Dimension
Köra neurala inbäddningsmodeller kräver betydande beräkningskraft. Vissa appar för fotorengöring laddar upp dina bilder till moln-GPU:er för analys - en enorm integritetsrisk. Moderna Apple-enheter inkluderar Neural Engine (16 kärnor på A17 Pro, 5 TOPS på M-serien), som kan köra CoreML vision-modeller helt på enheten. Detta innebär att 512-dimensionella inbäddningar kan beräknas för 10 000 foton på under 3 minuter utan att någon data lämnar enheten.
| Bearbetningsmetod | Hastighet (10K foton) | Sekretess | Noggrannhet |
|---|---|---|---|
| Cloud GPU (NVIDIA A100) | 30 sekunder | Foton laddade upp till externa servrar | Högsta (största modellerna) |
| Neuralmotor på enheten | 2-4 minuter | 100 % lokal, noll nätverksöverföring | Utmärkt (optimerade CoreML-modeller) |
| Endast CPU på enheten | 15-25 minuter | 100 % lokal | Bra (begränsad modellkomplexitet) |
Se Neural Duplicate Detection in Action
Swipe Photo Cleaner (Wipe AI) kombinerar perceptuell hash för snabb initial filtrering med CoreML neurala inbäddningar på enheten för djup semantisk gruppering. Resultatet: seriesekvenser, filtrerade kopior och nästan identiska kompositioner grupperas automatiskt med det skarpaste fotot markerat - allt bearbetas lokalt på din enhets Neural Engine utan att ladda upp en enda byte till molnet.
iPhone Minneskalkylator & Besparingsberäknare
Beräkna hur mycket gigabyte och iCloud-kronor du kan frigöra
HEIC vs JPEG Lagringsbesparing
Jämför filstorlekar och lagringsutrymme på din iPhone
4K & HD Videokomprimeringskalkylator
Beräkna hur mycket gigabyte du sparar genom att komprimera mobilvideor