同じカフェラテを 7 ショット撮ります。それぞれはわずかに異なります。角度がわずかに変化したり、照明がわずかに変化したり、手が 2 センチメートル移動しただけです。暗号化ハッシュ関数 (MD5、SHA-256) にとって、これら 7 枚の写真は完全に一意であり、1 ビットも一致しません。人間の目には、それらは本質的に同一に見えます。
マシンレベルの一意性と人間が認識する類似性との間のギャップは、知覚ハッシュによって解決される根本的な問題です。これは、最新のすべての重複写真クリーナーの背後にある中核テクノロジーであり、その仕組みを理解すると、一部のクリーナーが他のクリーナーよりも劇的に精度が高い理由がわかります。
5 レベルの写真類似性検出
写真の類似性はスペクトル上で作用します。最新の検出システムは複数の技術を同時に使用し、それぞれが異なるレベルに合わせて最適化されています。
| レベル | 検出方法 | 何がキャッチできるか | 速度 | 精度 |
|---|---|---|---|---|
| 1.バイト同一 | 暗号化ハッシュ (MD5/SHA-256) | ファイルの正確なコピー、AirDrop の複製 | 最速 | 100% (ただし狭い) |
| 2.ピクセルが同一 | 平均ハッシュ (aHash) | 同じ画像の再保存または再エンコードされたバージョン | 非常に速い | 85% |
| 3.見た目が似ている | 知覚ハッシュ (pHash/dHash) | トリミング、フィルタリング、またはわずかに回転したバージョン | 高速 | 92% |
| 4.意味的に類似 | ニューラル埋め込み (CNN/ビジョントランスフォーマー) | 同じシーンを別の角度から撮影したバースト シーケンス | 中程度 | 97% |
| 5.概念的に関連 | CLIP スタイルのマルチモーダル モデル | 同じ被写体またはテーマの異なる写真 | 遅い | コンテキスト依存 |
MD5 チェックサムが視覚的重複の 80% を見逃す理由
MD5 や SHA-256 などの暗号化ハッシュは、視覚的な類似性ではなく、データの整合性を検証するために設計されました。これらは固定長のダイジェストを生成し、 入力の単一ビットを変更すると完全に異なるハッシュが生成されます。これは次のことを意味します:
- 別の品質レベルで JPEG を再保存 → まったく新しいハッシュ
- HEIC から JPEG への変換 → まったく新しいハッシュ
- 端から 2 ピクセルをトリミング → 完全に新しいハッシュ
- Instagram フィルターの追加 → まったく新しいハッシュ
- 同じ写真のスクリーンショット → まったく新しいハッシュ
実際のカメラロールでは、正確なバイトレベルのコピーである重複はわずか約 15 ~ 20% です (通常は AirDrop 転送またはクラウド同期エラーによるもの)。残りの 80% は、 知覚分析が必要な視覚的複製です。
知覚的ハッシュの仕組み (pHash と dHash)
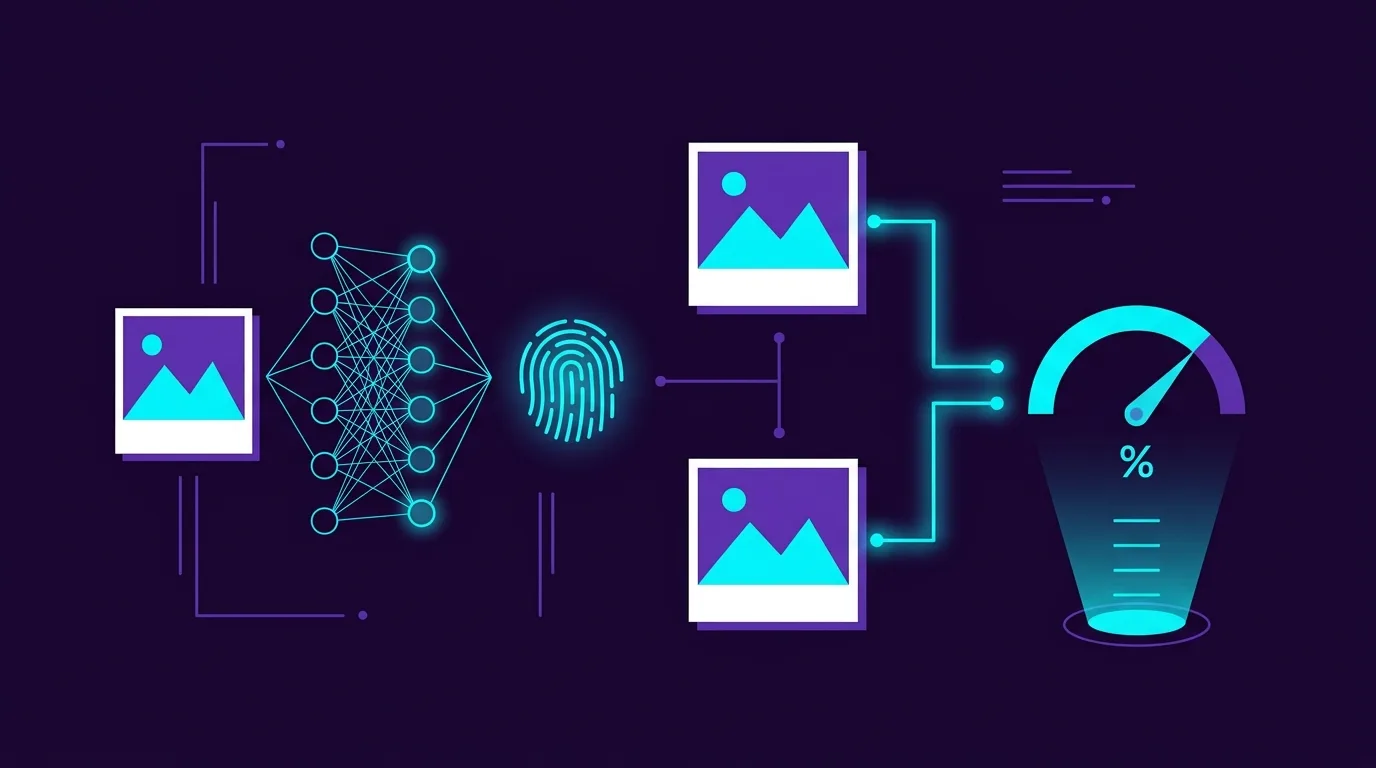
知覚ハッシュは、生のバイト内容ではなく、 画像の視覚構造をキャプチャするコンパクトなフィンガープリントを生成します。アルゴリズムは一般的なパイプラインに従います。
- 小さなグリッドにサイズ変更する: 画像は小さな解像度 (通常は 8×8 または 32×32 ピクセル) にダウンスケールされ、細部は破壊されますが、全体的な輝度構造は維持されます。
- グレースケールに変換: カラー情報は破棄されます。知覚的な類似性は主に色相ではなく構造に関するものです。暖かいフィルターを使用した写真と冷たいフィルターを使用した写真は一致するはずです。
- 勾配または平均を計算する: dHash (差分ハッシュ) の場合、各ピクセルがその右隣のピクセルと比較されます。 aHash (平均ハッシュ) の場合、各ピクセルはグリッドの平均輝度と比較されます。各比較により、明るい方 = 1、暗い方 = 0 という 1 つのビットが生成されます。
- バイナリ フィンガープリントの生成: 結果は、64 ビット (8×8) または 1024 ビット (32×32) のバイナリ文字列、つまり知覚ハッシュです。
- ハミング距離を使用して比較: 2 つのイメージは、ハッシュ間のビット数の違いを数えることによって比較されます。ハミング距離 0 = 同一の構造。距離 ≤ 5 (64 点中) = 視覚的にほぼ同一。距離 ≤ 10 = おそらく同様です。
フィルタリングされた写真で pHash が機能する理由
アルゴリズムはステップ 1 ~ 2 で色と細部を破棄するため、Instagram でフィルタリングされたバージョンの写真は、元の写真とほぼ同じ知覚ハッシュを生成します。大規模な輝度構造 (上部の明るい空、下部の暗い地面) は、カラー グレーディングに関係なく同一のままです。
SSIM: 人間の目が実際に見ているものを測定する
Wang らが開発した構造類似性指数 (SSIM)。 2004 年にはバイナリ ハッシュを超えました。人間の視覚を反映する 3 つのコンポーネントに基づいて、連続的な類似性スコア (0.0 ~ 1.0) を計算します。
- 輝度の比較: 平均輝度レベルは似ていますか? (露出の違いを補正します)
- コントラストの比較: 画像には同様のダイナミック レンジがありますか?
- 構造の比較: 明るい領域と暗い領域の空間パターンは一致していますか?
SSIM スコアが 0.92 を超える場合は、通常、2 つの画像がほとんどの視聴者にとって知覚的に区別できないことを示します。最新のフォト クリーナーは、このしきい値を使用して、真に異なる構成を維持しながら、重複に近いものに自動的にフラグを立てます。
ニューラル埋め込み: 深層学習のフロンティア
知覚ハッシュは意味論的な類似性、つまり異なる位置から撮影された同じシーンの写真や、フレーム間で被写体が大きく動いたバースト シーケンスと格闘します。このような場合、オンデバイスのニューラル ネットワーク (畳み込みモデルまたは Vision Transformer モデル) が高次元の埋め込みベクトルを抽出します。
その仕組みは次のとおりです。ニューラル ネットワークは各写真を処理し、512 次元の浮動小数点数ベクトル を出力します。これは基本的に、画像の意味内容をエンコードする 512 個の数値です。同じ夕日を数秒間隔で異なる角度から撮影した写真は、この 512 次元空間内で幾何学的に近い埋め込みベクトルを生成します。
類似性はコサイン類似度、つまり 2 つのベクトル間の角度のコサインを使用して測定されます。コサイン類似度 1.0 = 同一の意味内容。 0.85+ のしきい値は、知覚的ハッシュだけでは見逃してしまうバースト シーケンス、ほぼ同一の構成、微妙な変化を捕捉します。
オンデバイス対クラウド処理: プライバシーの側面
ニューラル埋め込みモデルの実行には、かなりの計算能力が必要です。一部のフォト クリーナー アプリでは、分析のために画像をクラウド GPU にアップロードしますが、これは大きなプライバシー リスクとなります。最新の Apple デバイスには、CoreML ビジョン モデルを完全にデバイス上で実行できるニューラル エンジン (A17 Pro では 16 コア、M シリーズでは 5 TOPS) が搭載されています。これは、デバイスからデータを送信することなく、10,000 枚の写真に対して 512 次元の埋め込みを 3 分以内に計算できることを意味します。
| 処理アプローチ | 速度 (10,000 枚の写真) | プライバシー | 精度 |
|---|---|---|---|
| クラウド GPU (NVIDIA A100) | 30 秒 | 外部サーバーにアップロードされた写真 | 最高(最大のモデル) |
| オンデバイス ニューラル エンジン | 2~4 分 | 100% ローカル、ネットワーク送信なし | 優れた (最適化された CoreML モデル) |
| オンデバイス CPU のみ | 15 ~ 25 分 | 100% ローカル | 良好 (モデルの複雑さは限定的) |
ニューラル重複検出の動作を確認する
スワイプ フォト クリーナー (Wipe AI) は、高速な初期フィルタリングのための知覚ハッシュと、深いセマンティック グループ化のためのデバイス上の CoreML ニューラル埋め込みを組み合わせています。その結果、バースト シーケンス、フィルタリングされたコピー、およびほぼ同一の構図が自動的にクラスタリングされ、最も鮮明な写真が強調表示されます。これらはすべて、クラウドに 1 バイトもアップロードすることなく、デバイスのニューラル エンジン上でローカルに処理されます。