Tomas siete tragos del mismo café con leche. Cada uno es ligeramente diferente: un pequeño cambio de ángulo, un pequeño cambio de iluminación, tu mano se movió 2 centímetros. Para una función hash criptográfica (MD5, SHA-256), estas siete fotos son completamente únicas: ni un solo bit coincide. Para el ojo humano, son esencialmente idénticos.
Esta brecha entre la unicidad a nivel de máquina y la similitud percibida por los humanos es el problema fundamental que resuelve el hashing perceptual. Es la tecnología central detrás de cada limpiador de fotografías duplicadas moderno, y comprender cómo funciona revela por qué algunos limpiadores son dramáticamente más precisos que otros.
5 niveles de detección de similitudes fotográficas
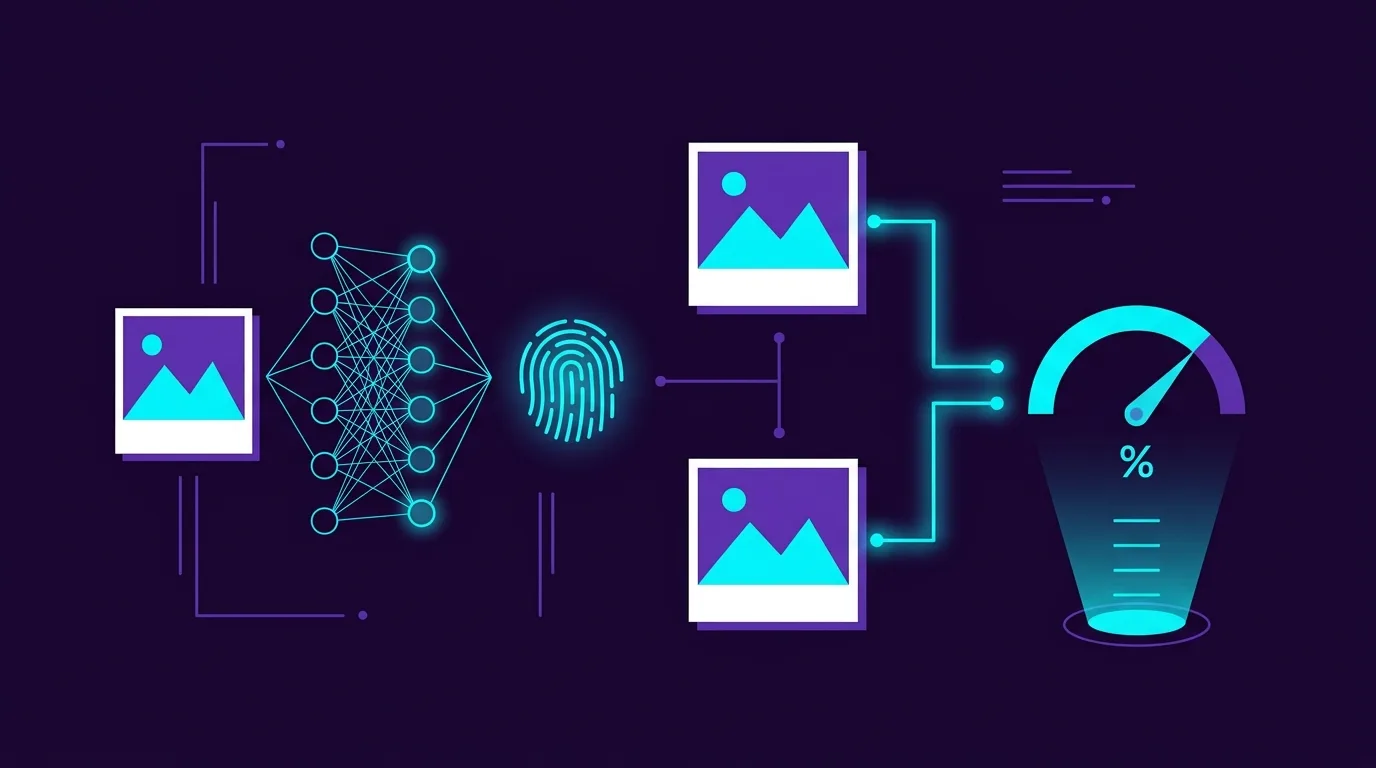
La similitud fotográfica opera en un espectro. Los sistemas de detección modernos utilizan múltiples técnicas simultáneamente, cada una optimizada para un nivel diferente:
| Nivel | Método de detección | Lo que atrapa | Velocidad | Exactitud |
|---|---|---|---|---|
| Hash criptográfico (MD5/SHA-256) | Copias exactas de archivos, duplicados de AirDrop | Lo más rápido | 100% (pero estrecho) | |
| Hash promedio (aHash) | Versiones reguardadas o recodificadas de la misma imagen | muy rapido | 85% | |
| Hash perceptivo (pHash/dHash) | Versiones recortadas, filtradas o ligeramente rotadas | Rápido | 92% | |
| Incrustaciones neuronales (CNN/Vision Transformer) | La misma escena desde diferentes ángulos, secuencias en ráfaga. | Moderado | 97% | |
| Modelos multimodales estilo CLIP | Diferentes fotografías del mismo tema o tema. | Lento | Dependiente del contexto |
Por qué las sumas de comprobación MD5 omiten el 80 % de los duplicados visuales
Los hashes criptográficos como MD5 y SHA-256 se diseñaron para verificar la integridad de los datos, no para la similitud visual. Producen un resumen de longitud fija en el que cambiar un solo bit en la entrada produce un hash completamente diferente. Esto significa:
- Volver a guardar un JPEG con un nivel de calidad diferente → hash completamente nuevo
- Conversión de HEIC a JPEG → hash completamente nuevo
- Recortar 2 píxeles desde el borde → hash completamente nuevo
- Agregar un filtro de Instagram → hash completamente nuevo
- Capturas de pantalla de la misma foto → hash completamente nuevo
En los carretes de las cámaras del mundo real, solo entre el 15% y el 20% de los duplicados son copias exactas a nivel de bytes (generalmente de transferencias AirDrop o errores de sincronización en la nube). El 80% restante son duplicados visuales que requieren análisis de percepción.
Cómo funciona el hash perceptivo (pHash y dHash)
El hash perceptual genera una huella digital compacta que captura la estructura visual de una imagen en lugar de su contenido de bytes sin formato. El algoritmo sigue un proceso general:
- Cambiar el tamaño a una cuadrícula pequeña: la imagen se reduce a una resolución pequeña (normalmente 8×8 o 32×32 píxeles), lo que destruye los detalles finos pero preserva la estructura de luminancia general.
- Convertir a escala de grises: La información de color se descarta. La similitud perceptiva tiene que ver principalmente con la estructura, no con el tono: una foto con un filtro cálido y otra con un filtro frío deberían coincidir.
- Calcular gradiente o promedio: Para dHash (hash de diferencia), cada píxel se compara con su vecino derecho. Para aHash (hash promedio), cada píxel se compara con la luminancia media de la cuadrícula. Cada comparación produce un único bit: más brillante = 1, más oscuro = 0.
- Producir huella digital binaria: El resultado es una cadena binaria de 64 bits (8×8) o 1024 bits (32×32): el hash perceptivo.
- Comparar usando la distancia de Hamming: Se comparan dos imágenes contando cuántos bits difieren entre sus hashes. Una distancia de Hamming de 0 = estructura idéntica. Distancia ≤ 5 (de 64) = visualmente casi idéntico. Distancia ≤ 10 = probablemente similar.
Por qué pHash funciona en fotos filtradas
Debido a que el algoritmo descarta el color y los detalles finos en los pasos 1 y 2, una versión de una foto filtrada por Instagram produce casi el mismo hash perceptual que la original. La estructura de luminancia a gran escala (cielo brillante arriba, suelo oscuro abajo) permanece idéntica independientemente de la gradación de color.
SSIM: medición de lo que realmente ve el ojo humano
El Índice de Similitud Estructural (SSIM), desarrollado por Wang et al. en 2004, va más allá del hash binario. Calcula una puntuación de similitud continua (0,0 a 1,0) basada en tres componentes que reflejan la percepción visual humana:
- Comparación de luminancia: ¿Son similares los niveles de brillo promedio? (Compensa las diferencias de exposición)
- Comparación de contraste: ¿Las imágenes tienen un rango dinámico similar?
- Comparación de estructuras: ¿Coinciden los patrones espaciales de las regiones claras y oscuras?
Una puntuación SSIM superior a 0,92 normalmente indica que dos imágenes son perceptualmente indistinguibles para la mayoría de los espectadores. Los limpiadores de fotografías modernos utilizan este umbral para marcar automáticamente los casi duplicados y, al mismo tiempo, conservar composiciones realmente diferentes.
Integraciones neuronales: la frontera del aprendizaje profundo
El hashing perceptivo lucha con la similitud semántica: fotografías de la misma escena tomadas desde diferentes posiciones o secuencias en ráfagas en las que el sujeto se movía significativamente entre fotogramas. Para estos casos, las redes neuronales en el dispositivo (modelos convolucionales o Vision Transformer) extraen vectores de incrustación de alta dimensión.
Así es como funciona: la red neuronal procesa cada foto y genera un vector flotante de 512 dimensiones, esencialmente 512 números que codifican el contenido semántico de la imagen. Las fotografías de la misma puesta de sol, tomadas con segundos de diferencia desde diferentes ángulos, producen vectores de incrustación que están geométricamente cerca en este espacio de 512 dimensiones.
La similitud se mide utilizando la similitud del coseno: el coseno del ángulo entre dos vectores. Una similitud coseno de 1,0 = contenido semántico idéntico. Un umbral de 0,85+ captura secuencias explosivas, composiciones casi idénticas y variaciones sutiles que el hash perceptivo por sí solo pasaría por alto.
Procesamiento en el dispositivo versus en la nube: la dimensión de privacidad
La ejecución de modelos de incrustación neuronal requiere una potencia de cálculo significativa. Algunas aplicaciones de limpieza de fotografías cargan sus imágenes en GPU en la nube para analizarlas, lo que representa un riesgo enorme para la privacidad. Los dispositivos Apple modernos incluyen el Neural Engine (16 núcleos en el A17 Pro, 5 TOPS en la serie M), capaz de ejecutar modelos de visión CoreML completamente en el dispositivo. Esto significa que se pueden calcular incrustaciones de 512 dimensiones para 10.000 fotos en menos de 3 minutos sin que ningún dato salga del dispositivo.
| Enfoque de procesamiento | Velocidad (10.000 fotos) | Privacidad | Precisión |
|---|---|---|---|
| GPU en la nube (NVIDIA A100) | 30 segundos | Fotos cargadas a servidores externos | Más alto (modelos más grandes) |
| Motor neuronal en el dispositivo | 2–4 minutos | 100% local, cero transmisión de red | Excelente (modelos CoreML optimizados) |
| CPU en el dispositivo únicamente | 15–25 minutos | 100% local | Bueno (complejidad del modelo limitada) |
Ver detección de duplicados neuronales en acción
Swipe Photo Cleaner (Wipe AI) combina hash perceptual para un filtrado inicial rápido con incrustaciones neuronales CoreML en el dispositivo para una agrupación semántica profunda. El resultado: secuencias en ráfaga, copias filtradas y composiciones casi idénticas se agrupan automáticamente con la foto más nítida resaltada; todo se procesa localmente en el Neural Engine de su dispositivo sin cargar un solo byte a la nube.