Sie machen sieben Aufnahmen desselben Latte Macchiato. Jedes ist etwas anders: eine kleine Winkeländerung, eine kleine Lichtverschiebung, Ihre Hand hat sich um 2 Zentimeter bewegt. Für eine kryptografische Hash-Funktion (MD5, SHA-256) sind diese sieben Fotos völlig einzigartig - kein einziges Bit stimmt überein. Für das menschliche Auge sind sie im Wesentlichen identisch.
Diese Lücke zwischen Einzigartigkeit auf Maschinenebene und vom Menschen wahrgenommener Ähnlichkeit ist das grundlegende Problem, das durch Wahrnehmungs-Hashing gelöst wird. Es ist die Kerntechnologie hinter jedem modernen Duplikat-Fotoreiniger, und wenn man versteht, wie es funktioniert, wird deutlich, warum einige Reiniger wesentlich genauer sind als andere.
5 Ebenen der Fotoähnlichkeitserkennung
Fotoähnlichkeit funktioniert in einem Spektrum. Moderne Erkennungssysteme verwenden mehrere Techniken gleichzeitig, die jeweils für eine andere Ebene optimiert sind:
| Ebene | Erkennungsmethode | Was es fängt | Geschwindigkeit | Genauigkeit |
|---|---|---|---|---|
| 1. Byteidentisch | Kryptografischer Hash (MD5/SHA-256) | Exakte Dateikopien, AirDrop-Duplikate | Am schnellsten | 100 % (aber eng) |
| 2. Pixelidentisch | Durchschnittlicher Hash (aHash) | Erneut gespeicherte oder neu codierte Versionen desselben Bildes | Sehr schnell | 85 % |
| 3. Optisch ähnlich | Wahrnehmungs-Hash (pHash/dHash) | Zugeschnittene, gefilterte oder leicht gedrehte Versionen | Schnell | 92 % |
| 4. Semantisch ähnlich | Neuronale Einbettungen (CNN/Vision Transformer) | Gleiche Szene aus verschiedenen Blickwinkeln, Burst-Sequenzen | Mäßig | 97 % |
| 5. Konzeptionell verwandt | Multimodale Modelle im CLIP-Stil | Verschiedene Fotos desselben Themas oder Themas | Langsam | Kontextabhängig |
Warum MD5-Prüfsummen 80 % der visuellen Duplikate übersehen
Kryptografische Hashes wie MD5 und SHA-256 wurden zur Überprüfung der Datenintegrität und nicht zur visuellen Ähnlichkeit entwickelt. Sie erzeugen einen Digest mit fester Länge, bei dem die Änderung eines einzelnen Bits in der Eingabe einen völlig anderen Hash erzeugt. Das bedeutet:
- Erneutes Speichern eines JPEG mit einer anderen Qualitätsstufe → völlig neuer Hash
- HEIC in JPEG konvertieren → völlig neuer Hash
- 2 Pixel vom Rand abschneiden → völlig neuer Hash
- Hinzufügen eines Instagram-Filters → völlig neuer Hash
- Screenshots desselben Fotos → völlig neuer Hash
In realen Kameraaufnahmen sind nur etwa 15-20 % der Duplikate exakte Kopien auf Byte-Ebene (normalerweise von AirDrop-Übertragungen oder Cloud-Synchronisierungsfehlern). Die restlichen 80 % sind visuelle Duplikate, die eine Wahrnehmungsanalyse erfordern.
Wie Perceptual Hashing funktioniert (pHash und dHash)
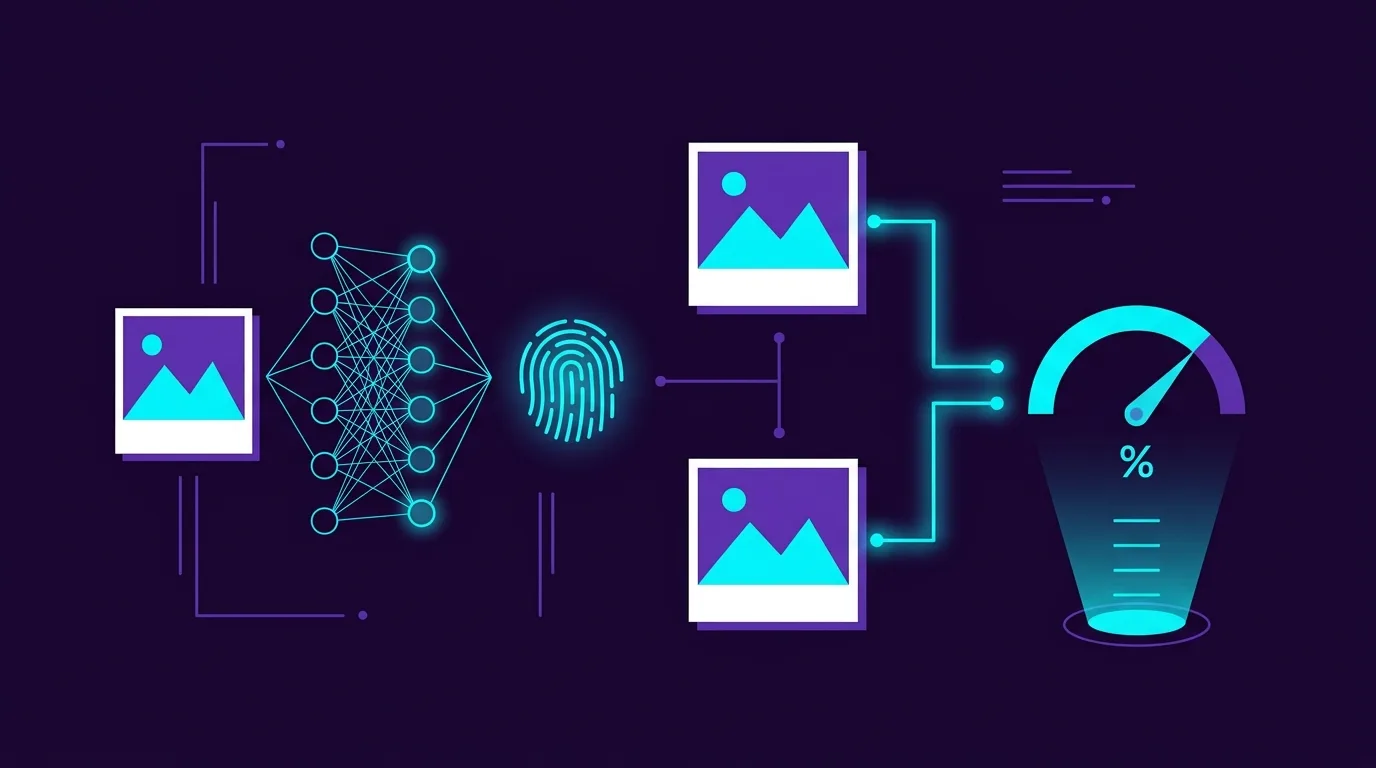
Wahrnehmungs-Hashing generiert einen kompakten Fingerabdruck, der die visuelle Struktur eines Bildes und nicht seinen rohen Byte-Inhalt erfasst. Der Algorithmus folgt einer allgemeinen Pipeline:
- Größe auf ein winziges Raster ändern: Das Bild wird auf eine kleine Auflösung (typischerweise 8×8 oder 32×32 Pixel) verkleinert, wodurch feine Details zerstört werden, aber die gesamte Luminanzstruktur erhalten bleibt.
- In Graustufen konvertieren: Farbinformationen werden verworfen. Bei der Wahrnehmungsähnlichkeit geht es in erster Linie um die Struktur, nicht um den Farbton - ein Foto mit einem warmen Filter und eines mit einem kalten Filter sollten immer noch übereinstimmen.
- Gradient oder Durchschnitt berechnen: Bei dHash (Differenz-Hash) wird jedes Pixel mit seinem rechten Nachbarn verglichen. Bei aHash (durchschnittlicher Hash) wird jedes Pixel mit der mittleren Luminanz des Rasters verglichen. Jeder Vergleich erzeugt ein einzelnes Bit: heller = 1, dunkler = 0.
- Binären Fingerabdruck erzeugen: Das Ergebnis ist eine 64-Bit (8×8) oder 1024-Bit (32×32) Binärzeichenfolge - der Wahrnehmungs-Hash.
- Vergleichen mit Hamming-Distanz: Zwei Bilder werden verglichen, indem gezählt wird, wie viele Bits sich zwischen ihren Hashes unterscheiden. Ein Hamming-Abstand von 0 = identische Struktur. Abstand ≤ 5 (von 64) = optisch nahezu identisch. Abstand ≤ 10 = wahrscheinlich ähnlich.
Warum pHash bei gefilterten Fotos funktioniert
Da der Algorithmus in Schritt 1-2 Farbe und feine Details verwirft, erzeugt eine Instagram-gefilterte Version eines Fotos nahezu den gleichen Wahrnehmungs-Hash wie das Original. Die großräumige Leuchtdichtestruktur - oben heller Himmel, unten dunkler Boden - bleibt unabhängig von der Farbkorrektur identisch.
SSIM: Messen, was das menschliche Auge tatsächlich sieht
Der Structural Similarity Index (SSIM), entwickelt von Wang et al. im Jahr 2004 geht über das binäre Hashing hinaus. Es berechnet einen kontinuierlichen Ähnlichkeitswert (0,0 bis 1,0) basierend auf drei Komponenten, die die menschliche visuelle Wahrnehmung widerspiegeln:
- Leuchtdichtevergleich: Sind die durchschnittlichen Helligkeitswerte ähnlich? (Kompensiert Belichtungsunterschiede)
- Kontrastvergleich: Haben die Bilder einen ähnlichen Dynamikumfang?
- Strukturvergleich: Stimmen die räumlichen Muster heller und dunkler Bereiche überein?
Ein SSIM-Wert über 0,92 weist typischerweise darauf hin, dass zwei Bilder für die meisten Betrachter wahrnehmungsmäßig nicht zu unterscheiden sind. Moderne Fotoreiniger nutzen diesen Schwellenwert, um Beinahe-Duplikate automatisch zu kennzeichnen und gleichzeitig wirklich unterschiedliche Kompositionen beizubehalten.
Neuronale Einbettungen: Die Grenze des Deep Learning
Wahrnehmungs-Hashing hat Probleme mit der semantischen Ähnlichkeit - Fotos derselben Szene, die aus verschiedenen Positionen aufgenommen wurden, oder Burst-Sequenzen, bei denen sich das Motiv zwischen den Bildern erheblich bewegt. In diesen Fällen extrahieren geräteinterne neuronale Netze (Faltungs- oder Vision-Transformer-Modelle) hochdimensionale Einbettungsvektoren.
So funktioniert es: Das neuronale Netzwerk verarbeitet jedes Foto und gibt einen 512-dimensionalen Float-Vektor aus - im Wesentlichen 512 Zahlen, die den semantischen Inhalt des Bildes kodieren. Fotos desselben Sonnenuntergangs, die im Abstand von Sekunden aus verschiedenen Winkeln aufgenommen wurden, erzeugen Einbettungsvektoren, die in diesem 512-dimensionalen Raum geometrisch nahe beieinander liegen.
Ähnlichkeit wird dann mithilfe der Kosinus-Ähnlichkeit gemessen: dem Kosinus des Winkels zwischen zwei Vektoren. Eine Kosinusähnlichkeit von 1,0 = identischer semantischer Inhalt. Ein Schwellenwert von 0,85+ erfasst Burst-Sequenzen, nahezu identische Kompositionen und subtile Variationen, die perzeptuelles Hashing allein übersehen würde.
On-Device vs. Cloud-Verarbeitung: Die Privatsphäre-Dimension
Das Ausführen neuronaler Einbettungsmodelle erfordert erhebliche Rechenleistung. Einige Photo Cleaner-Apps laden Ihre Bilder zur Analyse auf Cloud-GPUs hoch - ein enormes Datenschutzrisiko. Moderne Apple-Geräte verfügen über die Neural Engine (16 Kerne beim A17 Pro, 5 TOPS bei der M-Serie), die in der Lage ist, CoreML-Vision-Modelle vollständig auf dem Gerät auszuführen. Dies bedeutet, dass 512-dimensionale Einbettungen für 10.000 Fotos in weniger als 3 Minuten berechnet werden können, ohne dass Daten das Gerät verlassen.
| Verarbeitungsansatz | Geschwindigkeit (10.000 Fotos) | Datenschutz | Genauigkeit |
|---|---|---|---|
| Cloud-GPU (NVIDIA A100) | 30 Sekunden | Fotos auf externe Server hochgeladen | Höchste (größte Modelle) |
| Neuronale Engine auf dem Gerät | 2-4 Minuten | 100 % lokal, keine Netzwerkübertragung | Ausgezeichnet (optimierte CoreML-Modelle) |
| Nur On-Device-CPU | 15-25 Minuten | 100 % lokal | Gut (begrenzte Modellkomplexität) |
Sehen Sie sich die Erkennung neuronaler Duplikate in Aktion an
Swipe Photo Cleaner (Wipe AI) kombiniert perzeptuelles Hashing für eine schnelle anfängliche Filterung mit neuronalen CoreML-Einbettungen auf dem Gerät für eine tiefe semantische Gruppierung. Das Ergebnis: Burst-Sequenzen, gefilterte Kopien und nahezu identische Kompositionen werden automatisch gruppiert, wobei das schärfste Foto hervorgehoben wird - alles lokal auf der Neural Engine Ihres Geräts verarbeitet, ohne dass ein einziges Byte in die Cloud hochgeladen werden muss.
iPhone-Speicherpotenzial-Rechner
Schätzen Sie ab, wie viele Gigabytes Sie durch Duplikatbereinigung und Videokompression freigeben können.